首页 >> 活动与资讯 >> 行业资讯 > 低代码开发平台深度解析模型驱动架构与数据运行机制

低代码开发平台深度解析模型驱动架构与数据运行机制

作者头像超级管理员 发表于 2026/10/27 浏览次数:0
【摘要】 随着现代高校信息化建设迈入深水区,教务、科研、人事、学工、后勤等各类业务系统庞杂,传统的“烟囱式”建设模式导致数据孤岛频现,信息中心面临开发资源紧张与业务需求高频变动的双重压力。面对日益复杂的校园治理场景,如何通过底层技术架构的演进实现降本增效,成为众多高校关注的核心课题。本文将从技术视角出发,进行低代码开发平台深度解析模型驱动架构与数据运行机制,探讨如何以统一的数字化底座支撑高校内部应用的持续构建与系统协同。米缀AI低代码平台以原生AI为开发底座,为这一课题提供了具有参考价值的实践路径。

随着现代高校信息化建设迈入深水区,教务、科研、人事、学工、后勤等各类业务系统庞杂,传统的“烟囱式”建设模式导致数据孤岛频现,信息中心面临开发资源紧张与业务需求高频变动的双重压力。面对日益复杂的校园治理场景,如何通过底层技术架构的演进实现降本增效,成为众多高校关注的核心课题。本文将从技术视角出发,进行低代码开发平台深度解析模型驱动架构与数据运行机制,探讨如何以统一的数字化底座支撑高校内部应用的持续构建与系统协同。米缀AI低代码平台以原生AI为开发底座,为这一课题提供了具有参考价值的实践路径。

封面 (4).jpg

一、高校传统开发局限与模型驱动架构的演进

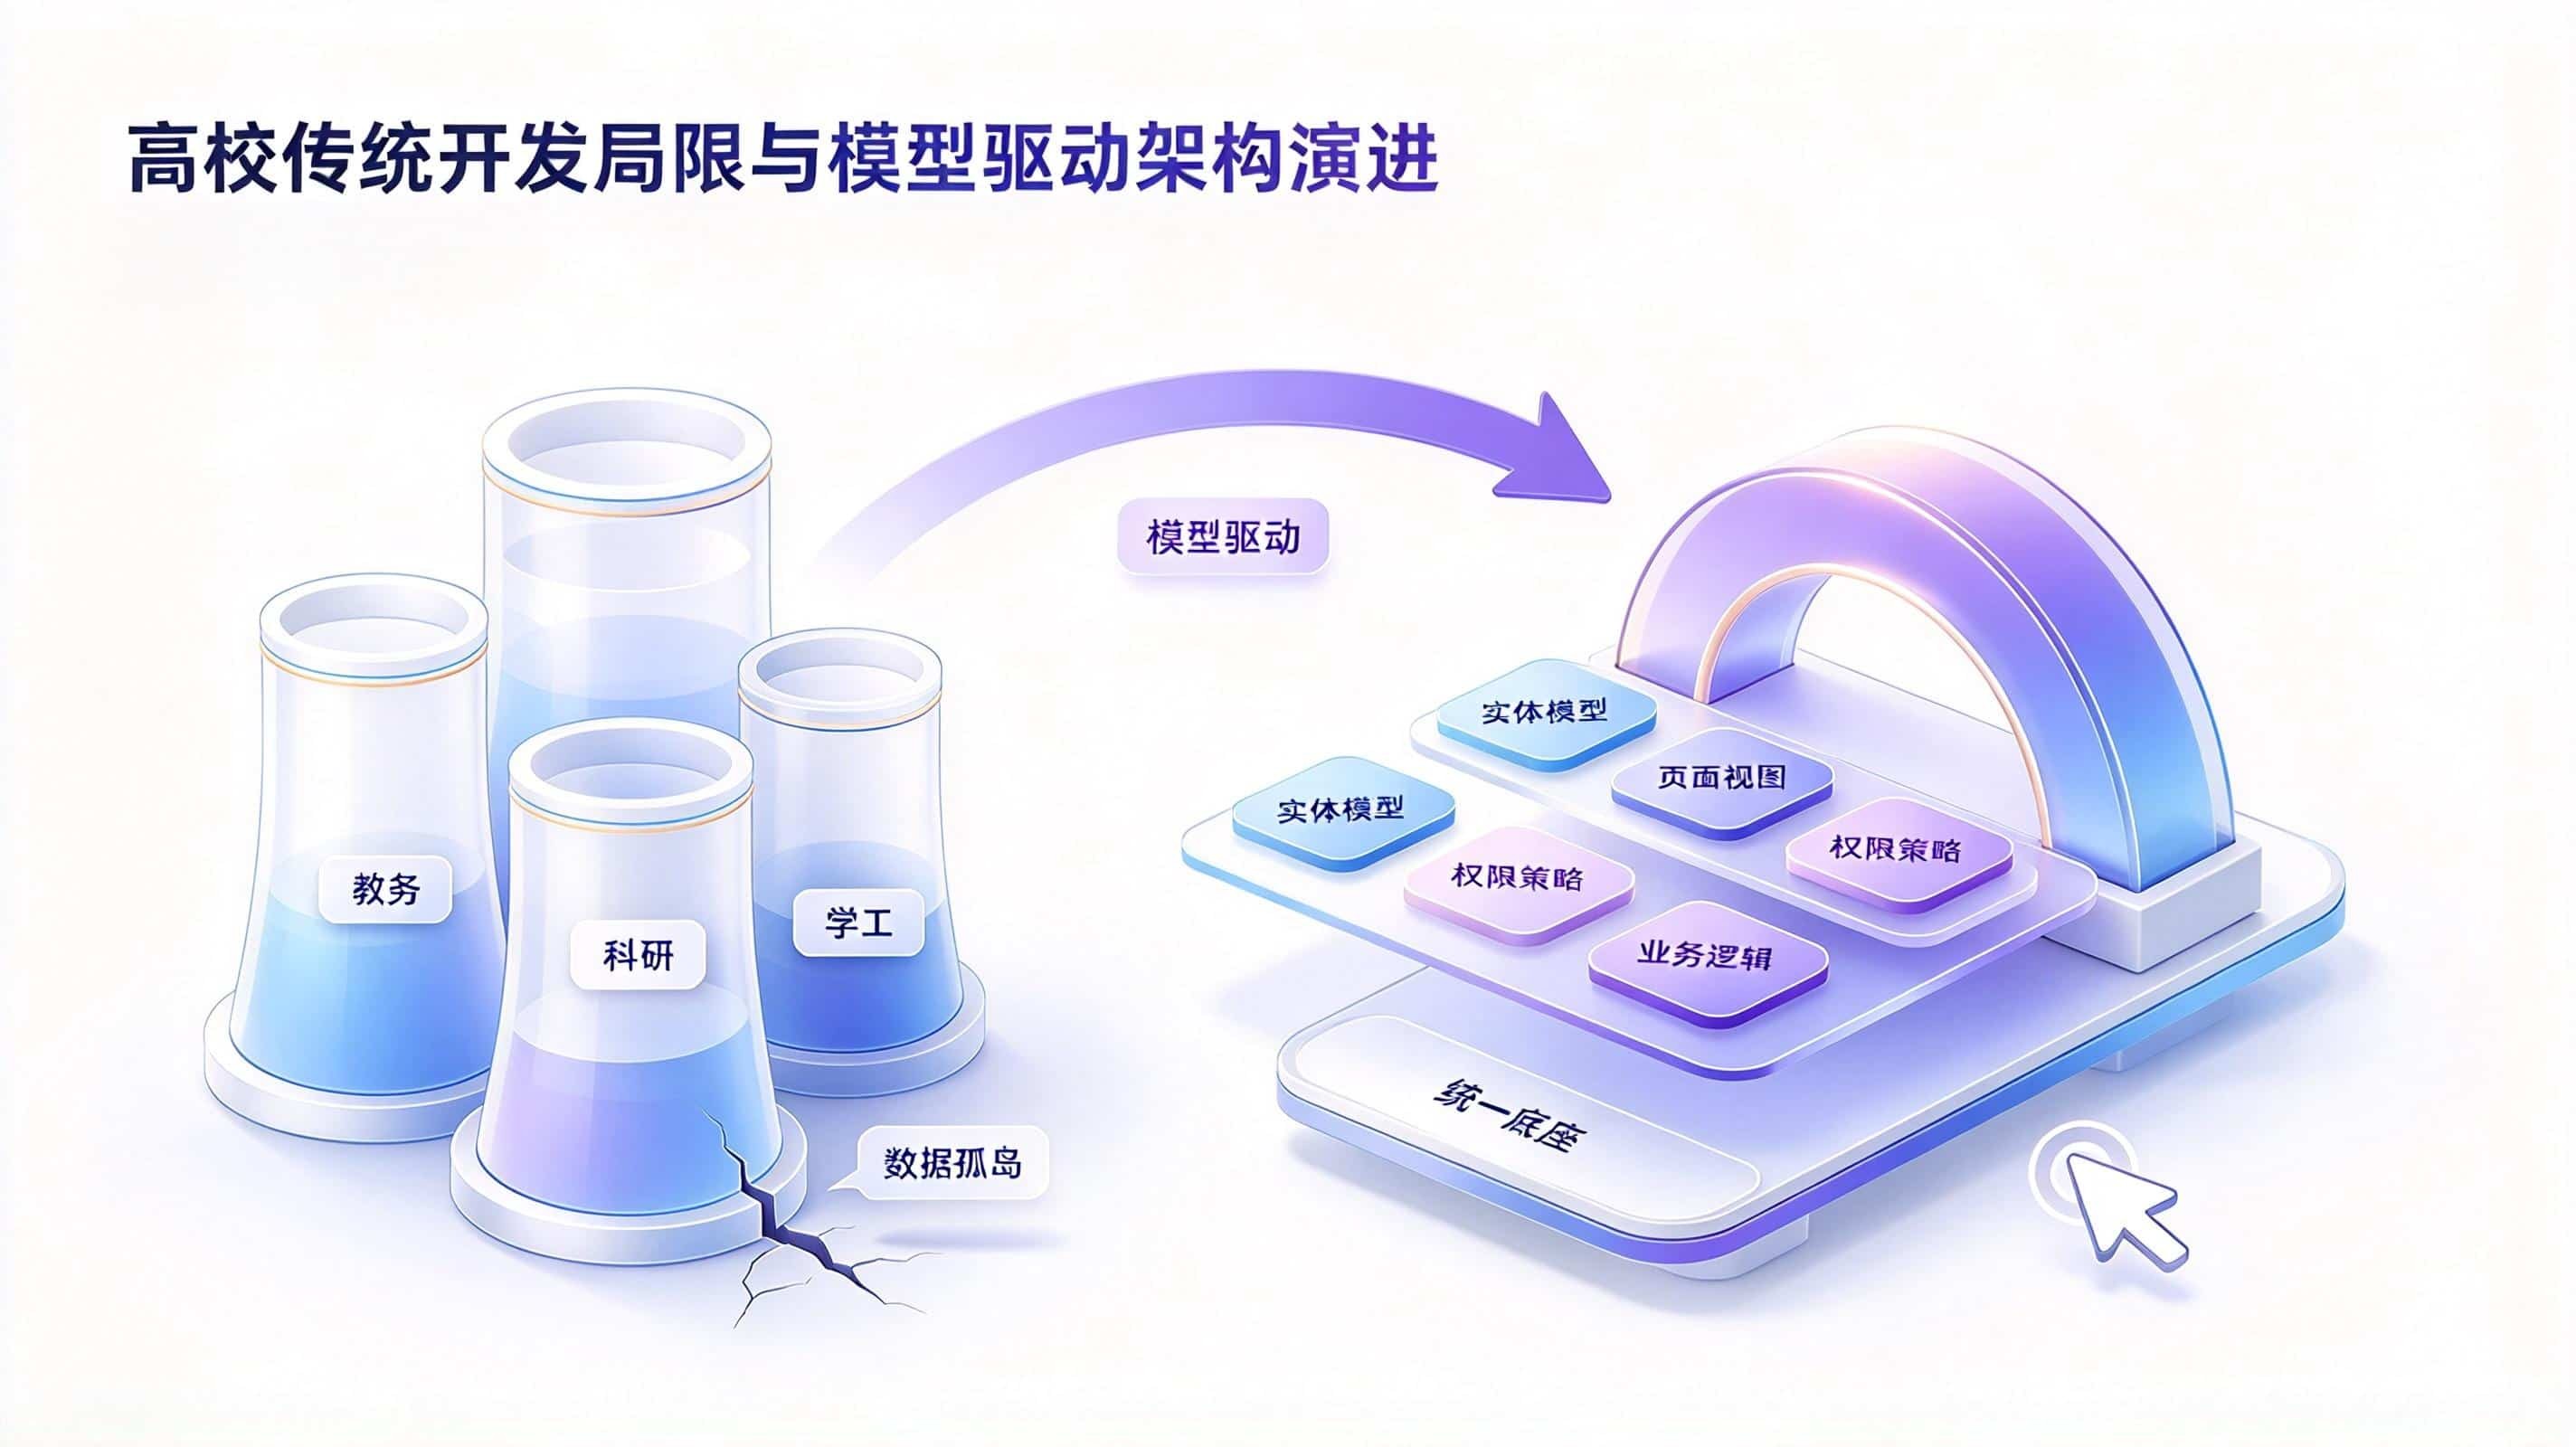
在传统的高校应用构建过程中,业务需求往往需要经历繁琐的调研、UI设计、前后端编码与联调测试。这种“代码堆砌”的模式高度依赖专业技术人员的个人经验,导致交付周期通常以月甚至年为单位计算。更为突出的问题在于,每一次新需求的引入(如评奖评优规则变更、科研项目申报流程调整)都可能意味着从零开始的基础建设,流程、接口与数据模型难以形成有效沉淀,信息中心常常陷入“重复造轮子”的困境。

为了突破这一瓶颈,企业级低代码平台引入了模型驱动架构。区别于早期的表单驱动,模型驱动架构将数据实体、业务逻辑、页面视图和权限策略进行抽象,转化为平台可识别的元数据模型。通过可视化拖拽与参数配置,平台能够自动解析模型并渲染出相应的应用程序。这种架构使得应用构建从“写代码”转变为“建模型”,业务人员与技术人员可以在统一的语义框架下协同工作,实现可视化生成多端应用。

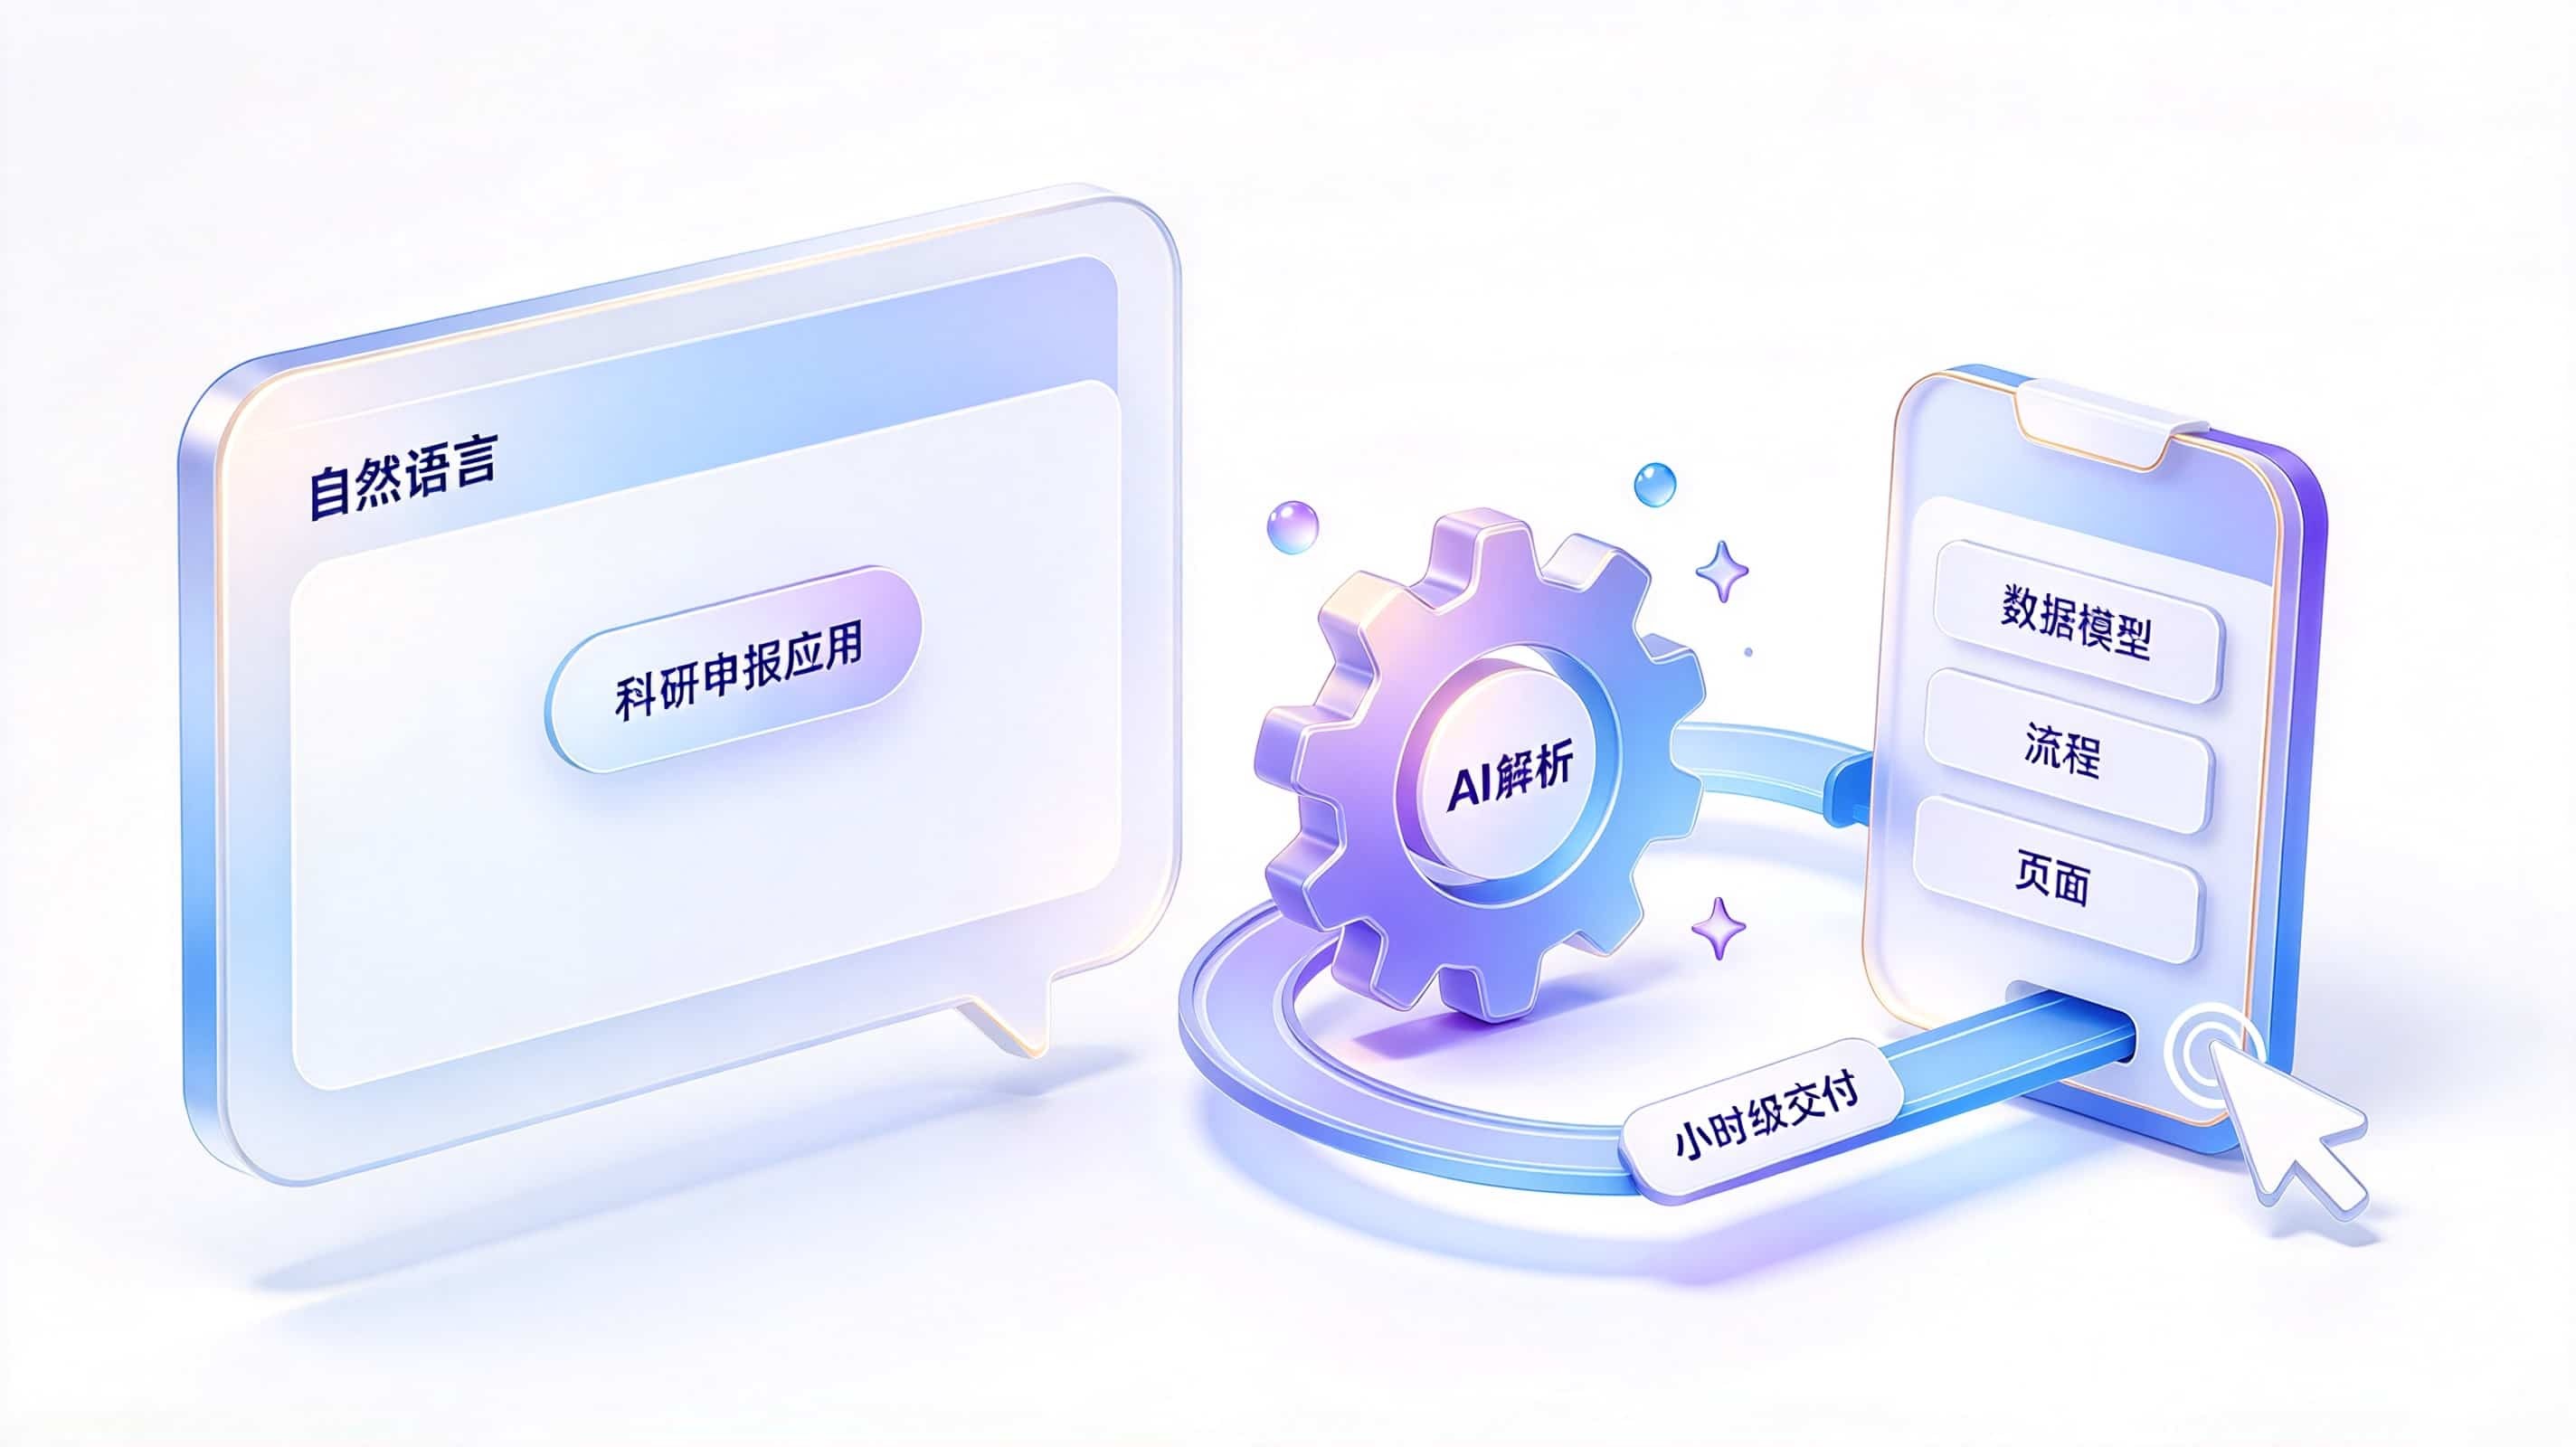
米缀AI低代码平台在此基础上更进一步,支持自然语言代码生成。平台内置的AI能力可以理解用户的自然语言描述,自主完成数据建模、页面生成、前后端逻辑编排。这种基于大模型与开发知识库深度融合的机制,让复杂应用的交付从数月缩减至小时级。在这一阶段,无论是零代码开发平台还是低代码开发平台,其核心价值均体现在对底层复杂度的封装,让高校的构建者聚焦于校园治理与教学科研业务本身。

1.jpg

二、AI大脑与双模式协同:重构高校应用构建范式

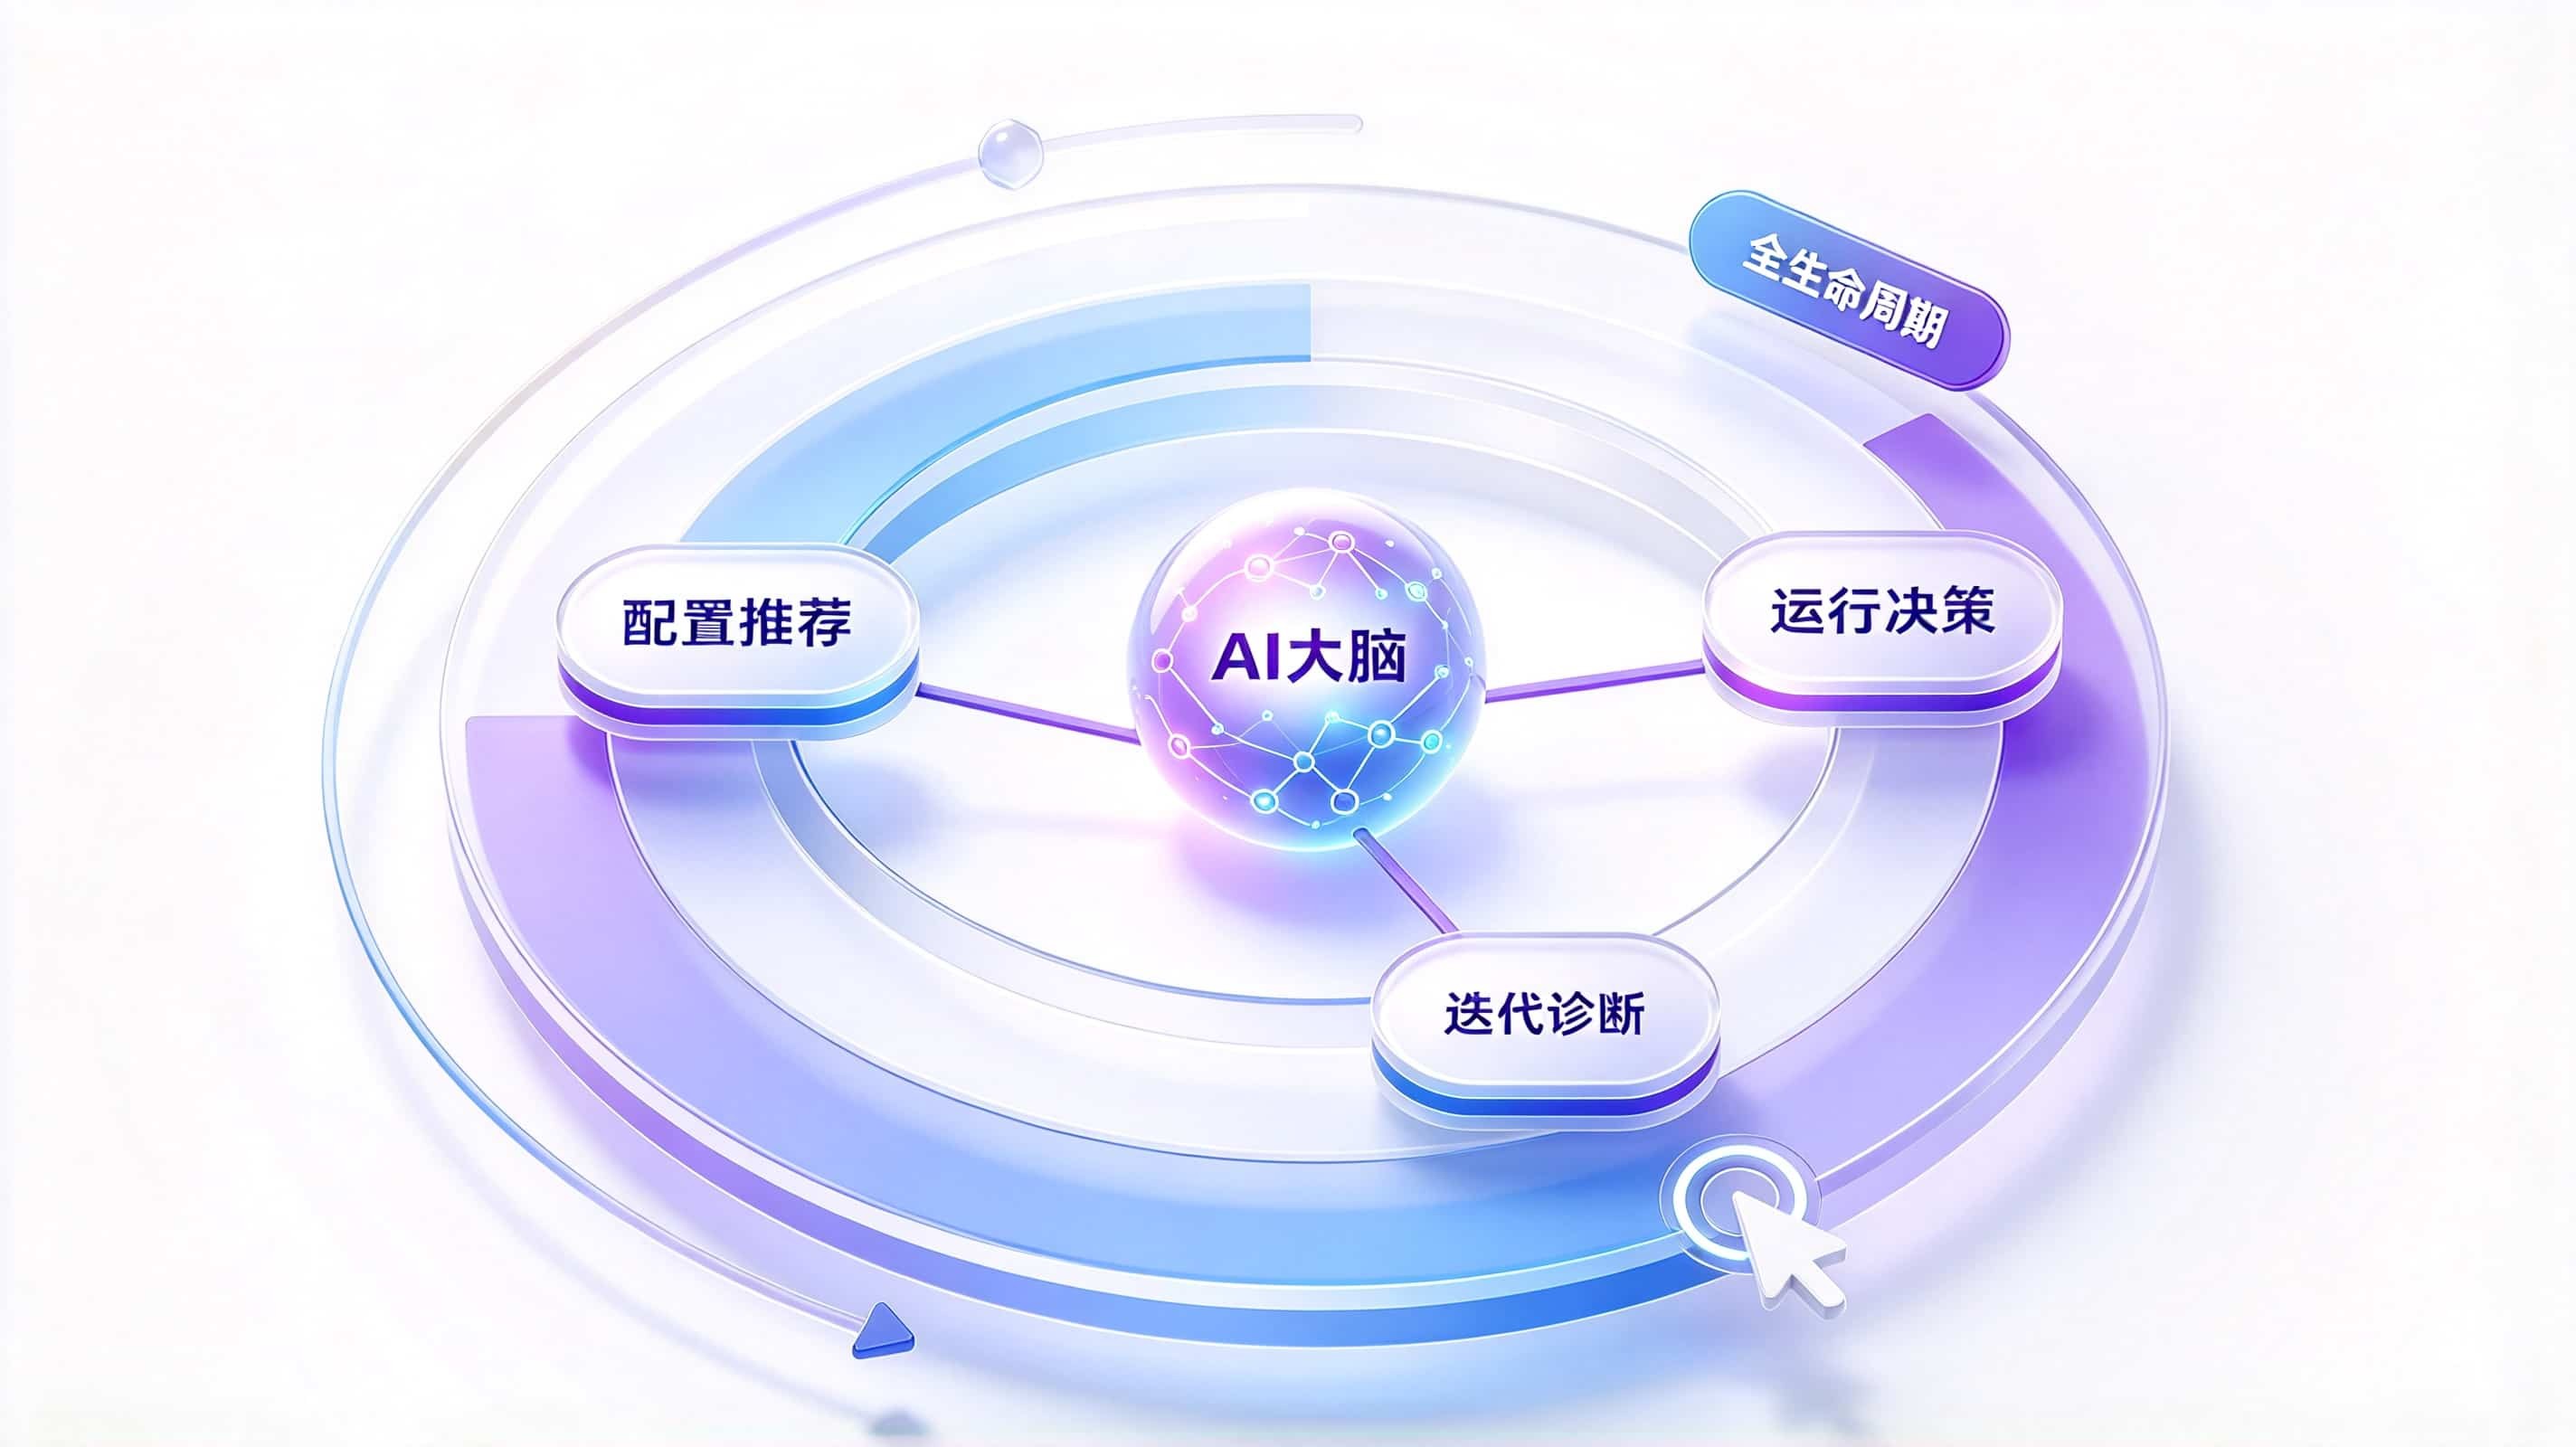
深入剖析低代码开发平台深度解析模型驱动架构与数据运行机制,不可忽视的是AI能力在其中的引擎作用。米缀AI低代码平台的核心特性之一是构建了贯穿应用全生命周期的AI大脑核心中枢。这一中枢作为平台的智慧灵魂,在配置时提供智能组件匹配与布局优化,在运行时实现自动化决策与异常诊断,构建出持续进化的应用体系。

平台采用AI/人工双开发模式,满足高校内部多样化的开发需求。一方面,AI全自主开发模式允许用户通过对话式交互,描述业务目标,AI自主拆解任务并产出包含数据实体、业务流程和权限体系的完整应用;另一方面,人工拖拽模式延续了可视化编排的优势,支持组件化、原子化操作与深度UI定制。两种模式可灵活切换,AI生成初版后,技术人员可通过自然语言微调或手动介入,实现构建效率与逻辑精度的平衡。

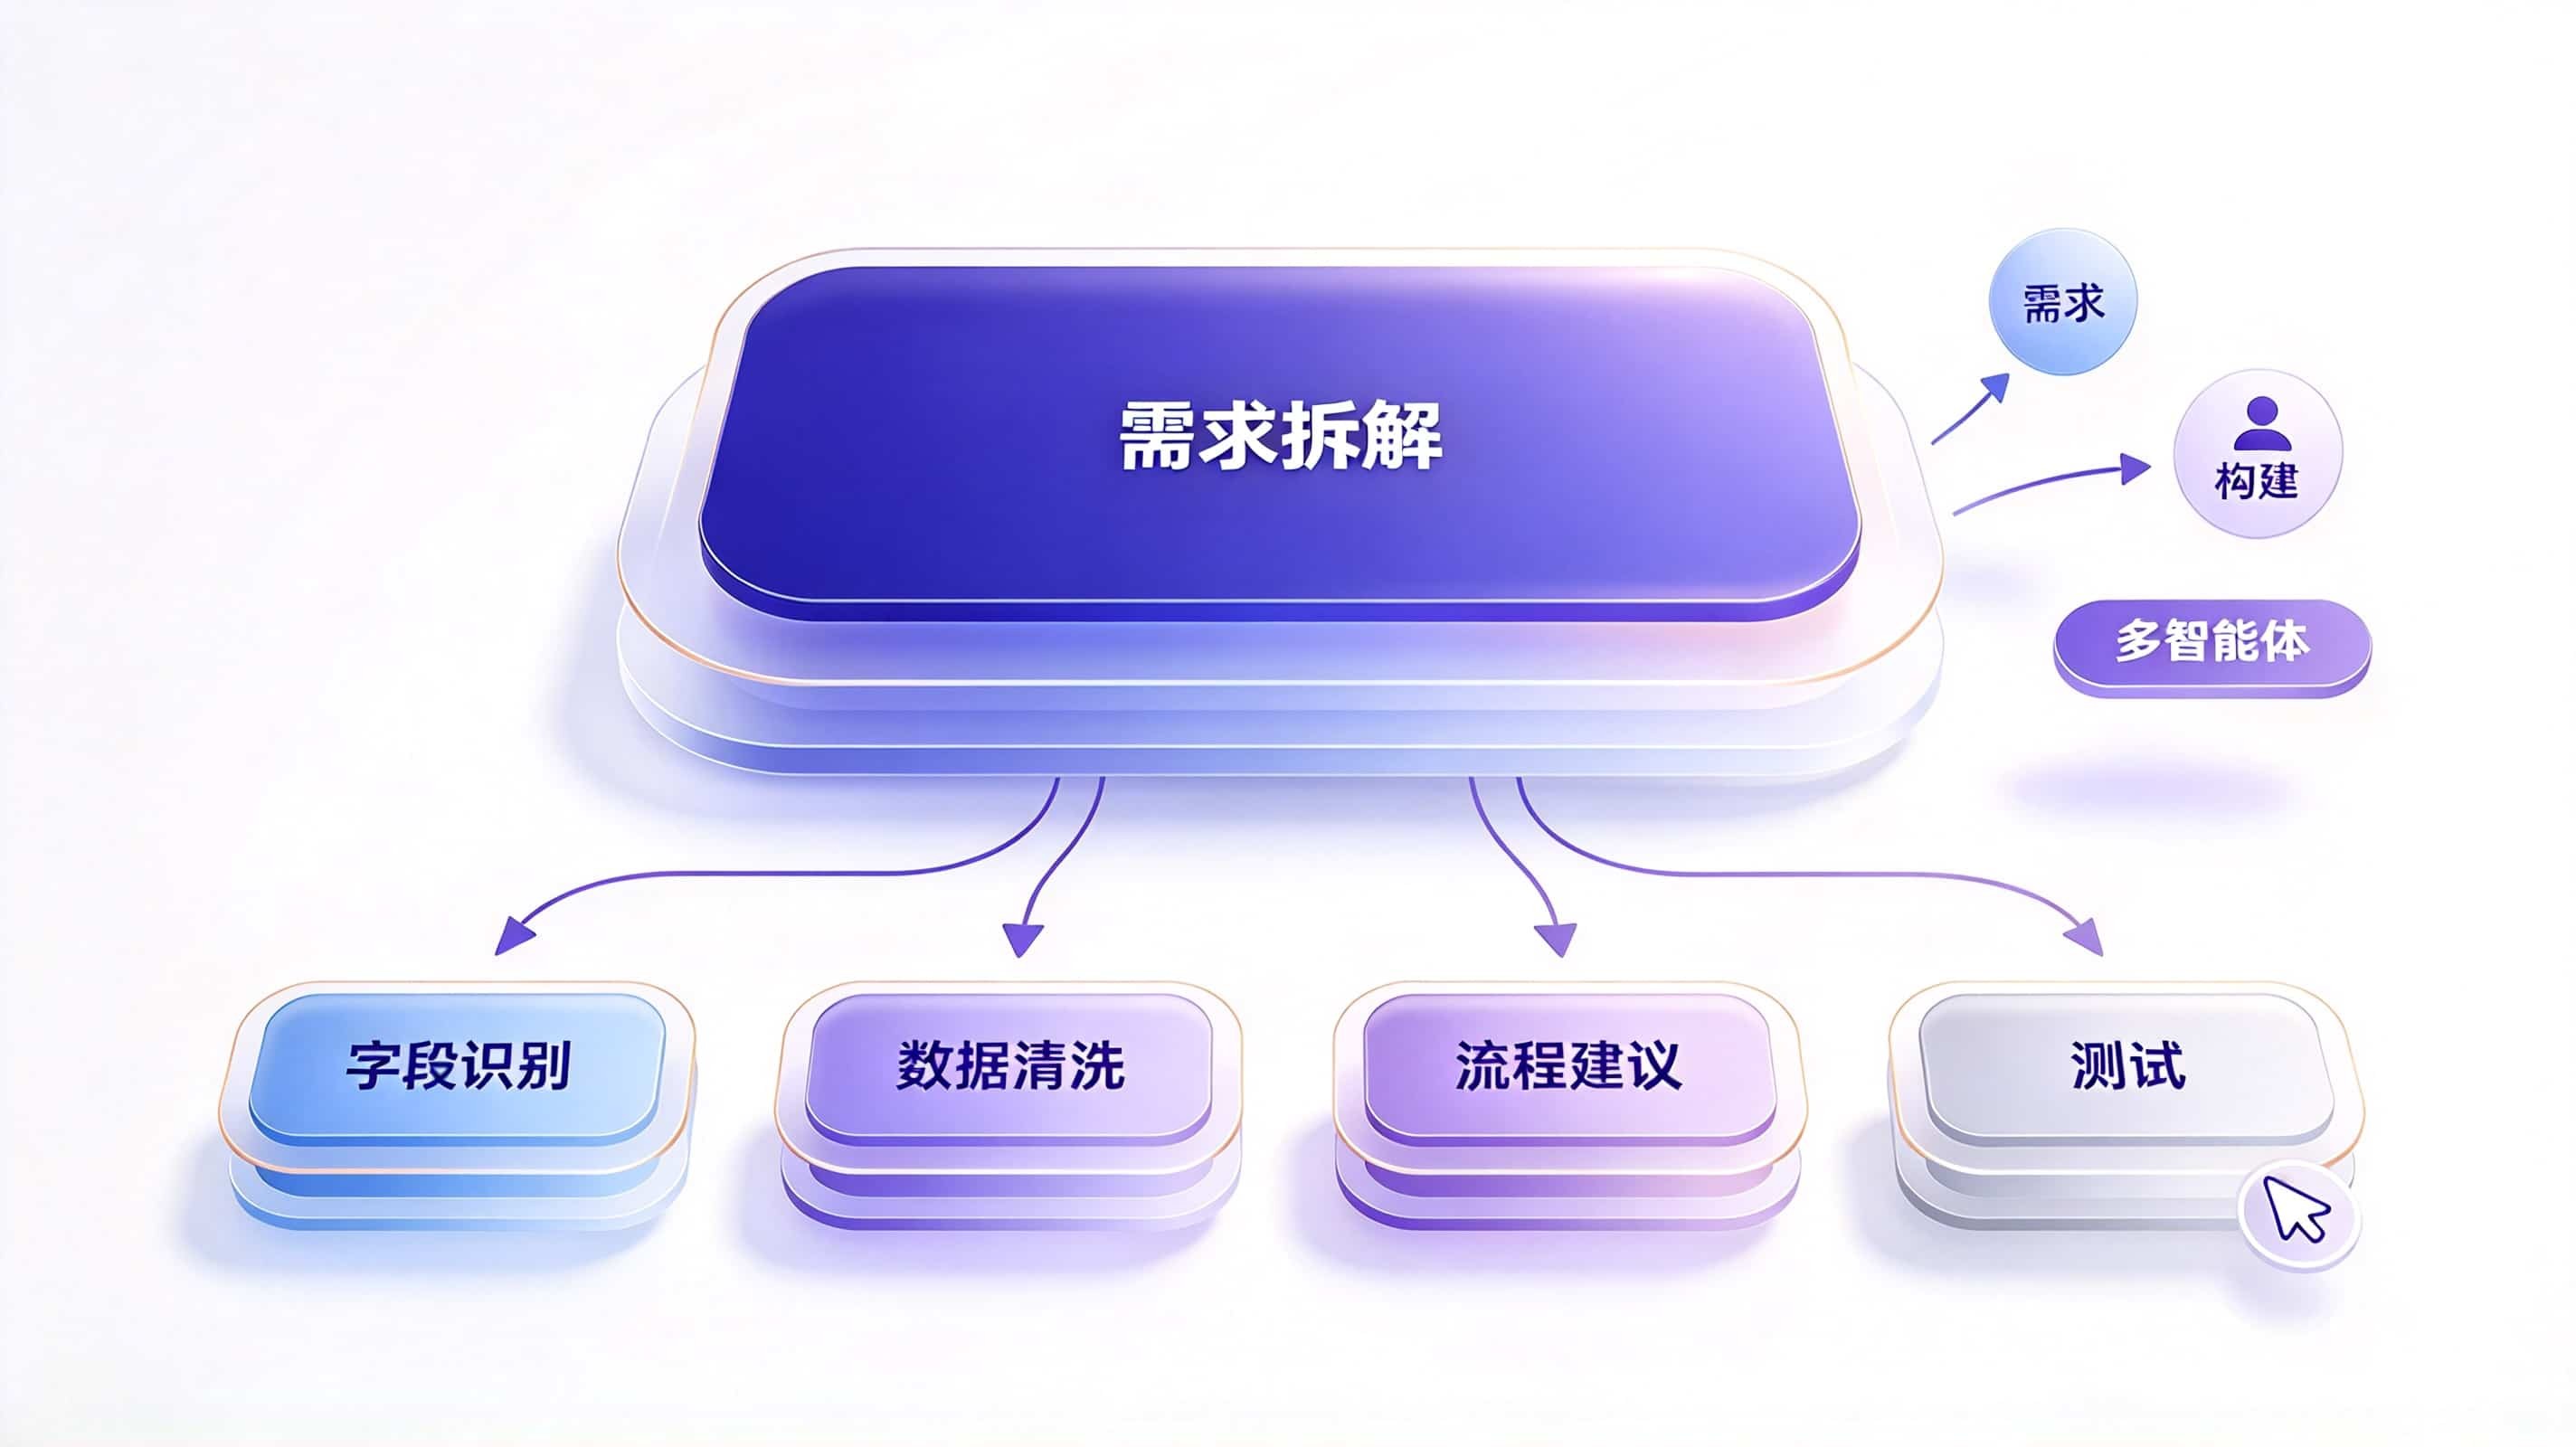
这种能力的背后,是大模型(LLM)与小模型(SLM)的协同架构。大模型负责自然语言需求拆解与复杂逻辑推理;小模型则针对字段识别、数据清洗、流程建议等特定任务进行微调,实现毫秒级响应。此外,平台内置了多智能体协作机制,需求分析、功能设计、前后台构建、测试等专业智能体模拟真实的研发团队协作流程,通过异步通信与状态同步,确保从需求到上线的全链路自动化与标准化。

3.jpg

三、流程引擎与数据工厂:全链路闭环与运行机制

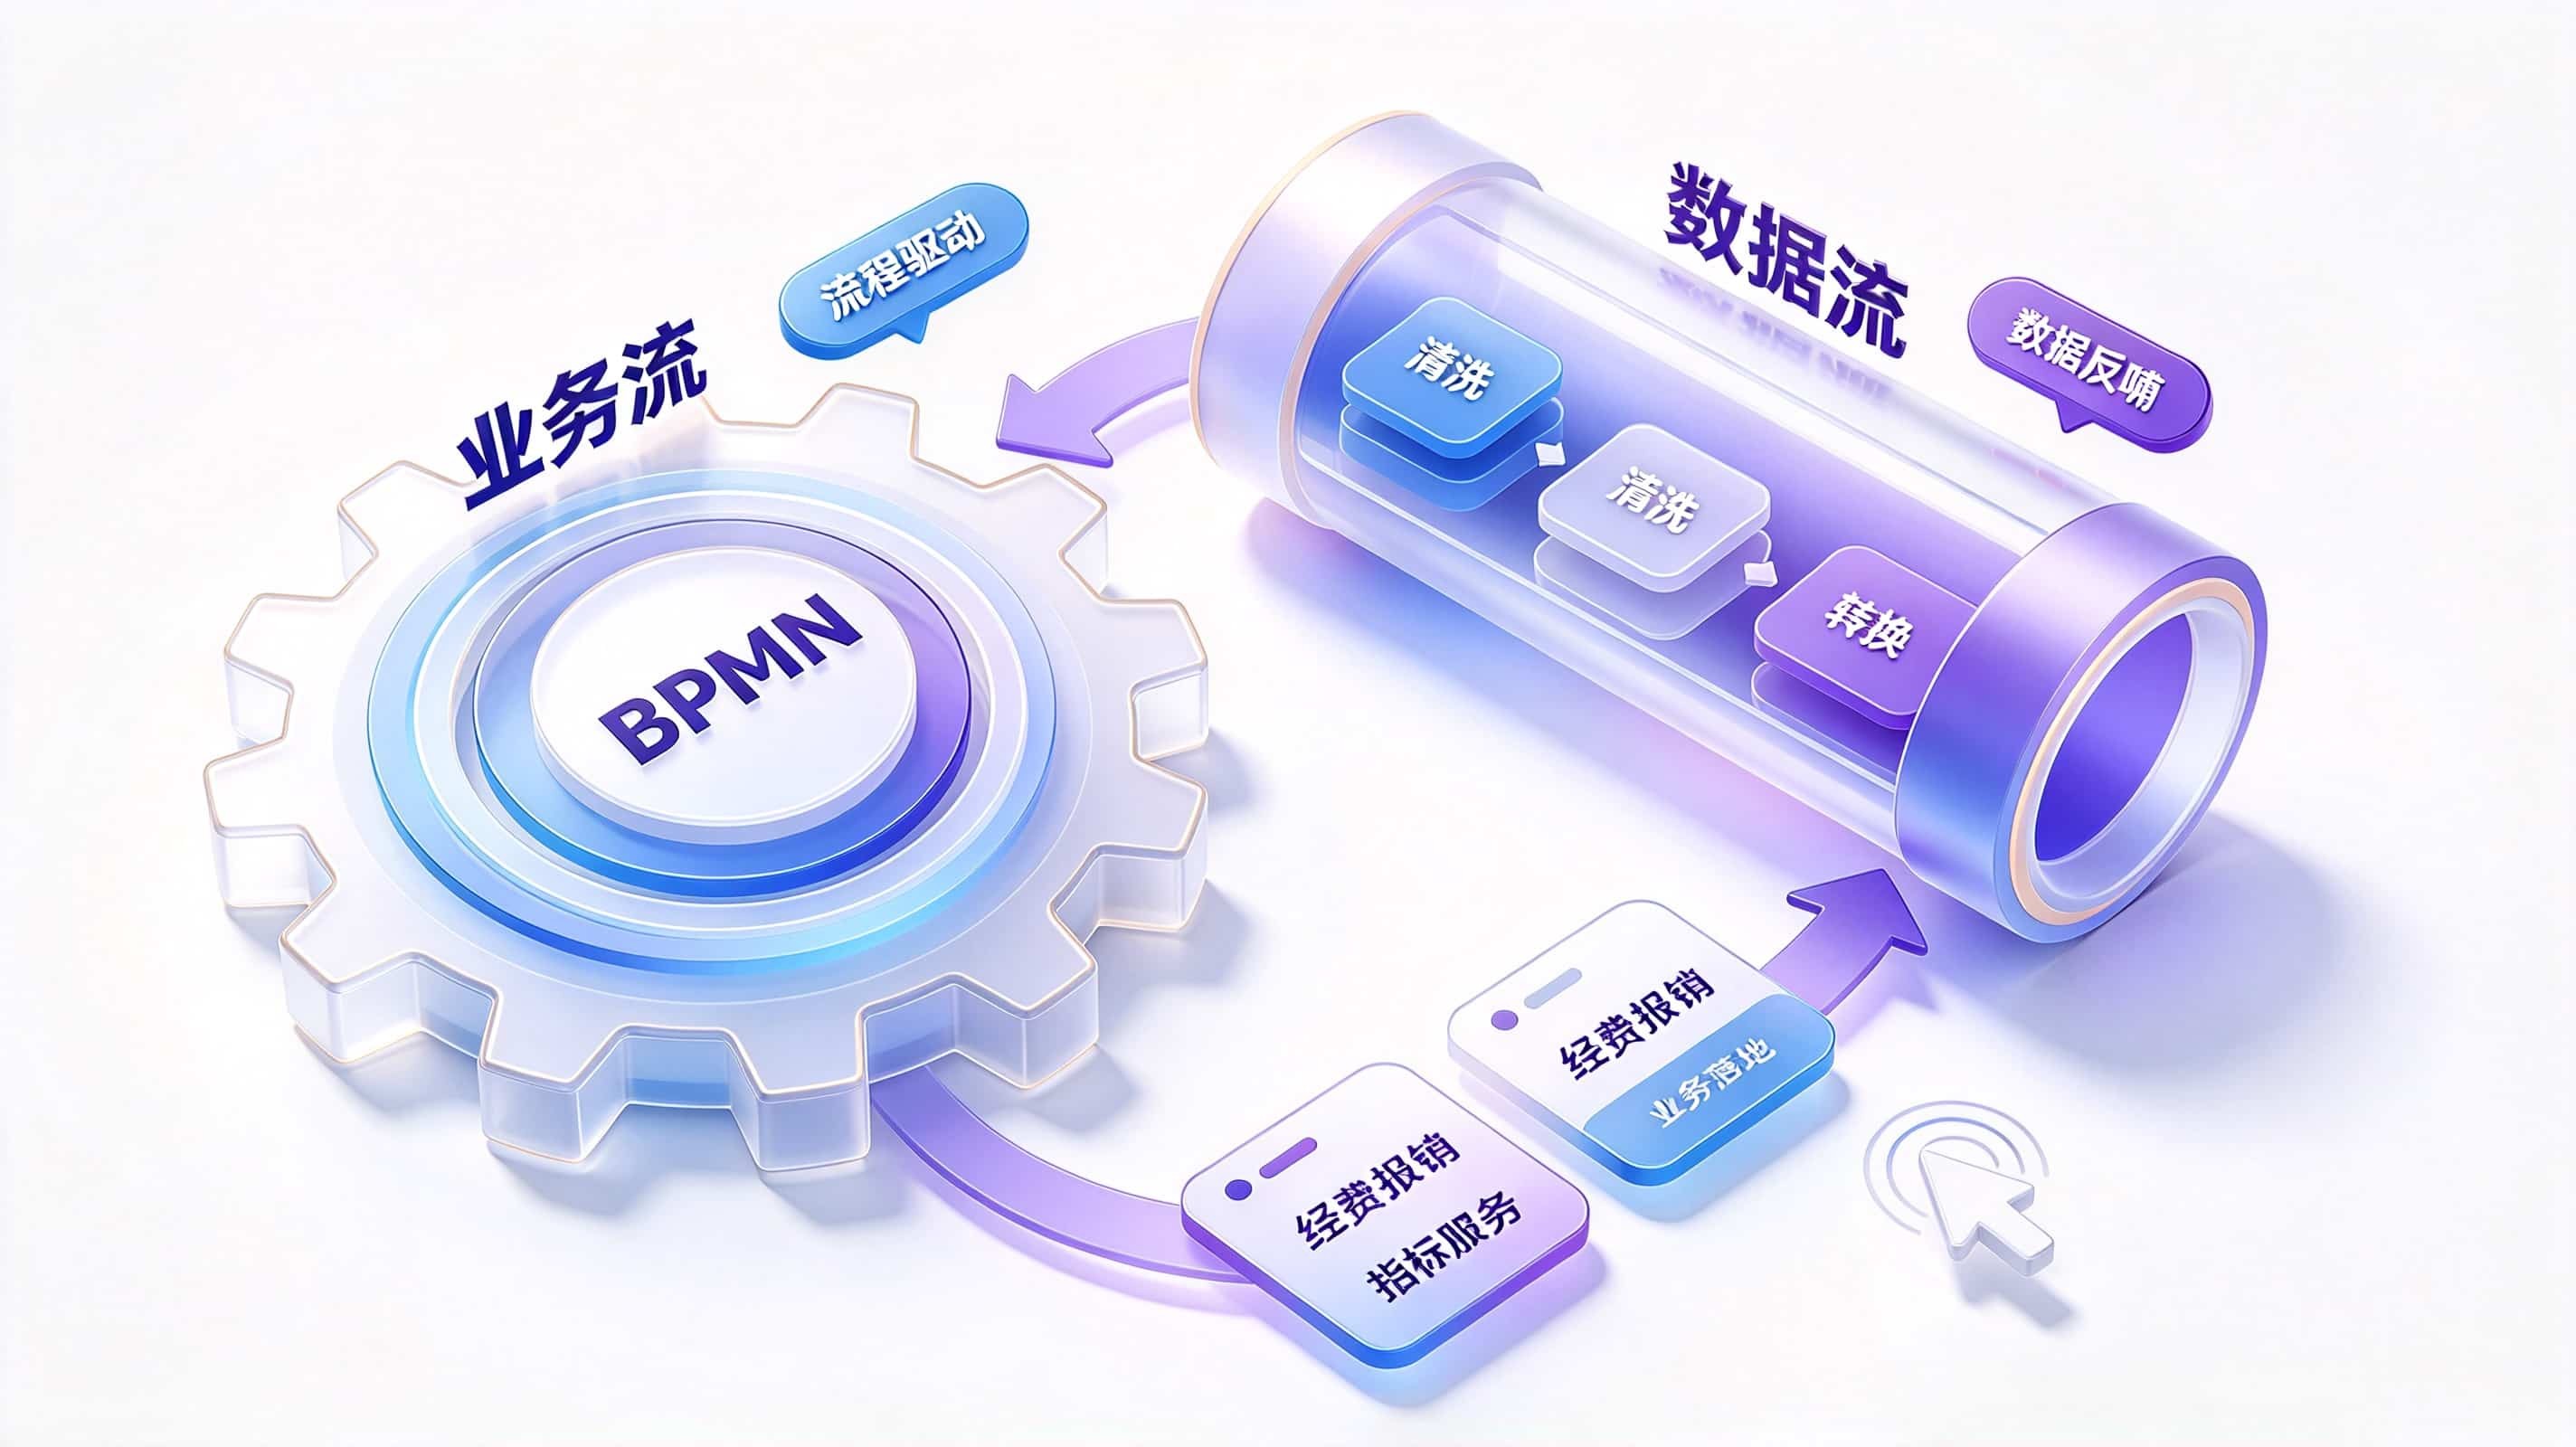
在AI低代码平台的构建中,业务流程的自动化与数据的流转加工是两大核心支柱。米缀AI低代码平台采用了“业务流+数据流”双引擎架构。业务流引擎基于BPMN2.0标准,支持顺序流、并行网关等复杂元素,内置事件驱动机制,适用于高校复杂的审批、工单与服务请求场景;数据流引擎则基于ETL/ELT范式,支持数据抽取、清洗、转换与加载全链路操作。

双引擎的联动构成了“流程驱动数据,数据反哺流程”的闭环。例如,在高校科研经费报销场景中,事项发起触发BPMN规则路由,责任人处理并更新数据状态,数据变化又反向触发消息提醒与财务看板同步。在教务指标数据服务场景中,多源数据接入后经过ETL清洗与标准化,加工成指标后再发布为数据服务,供管理看板或智能问数调用。

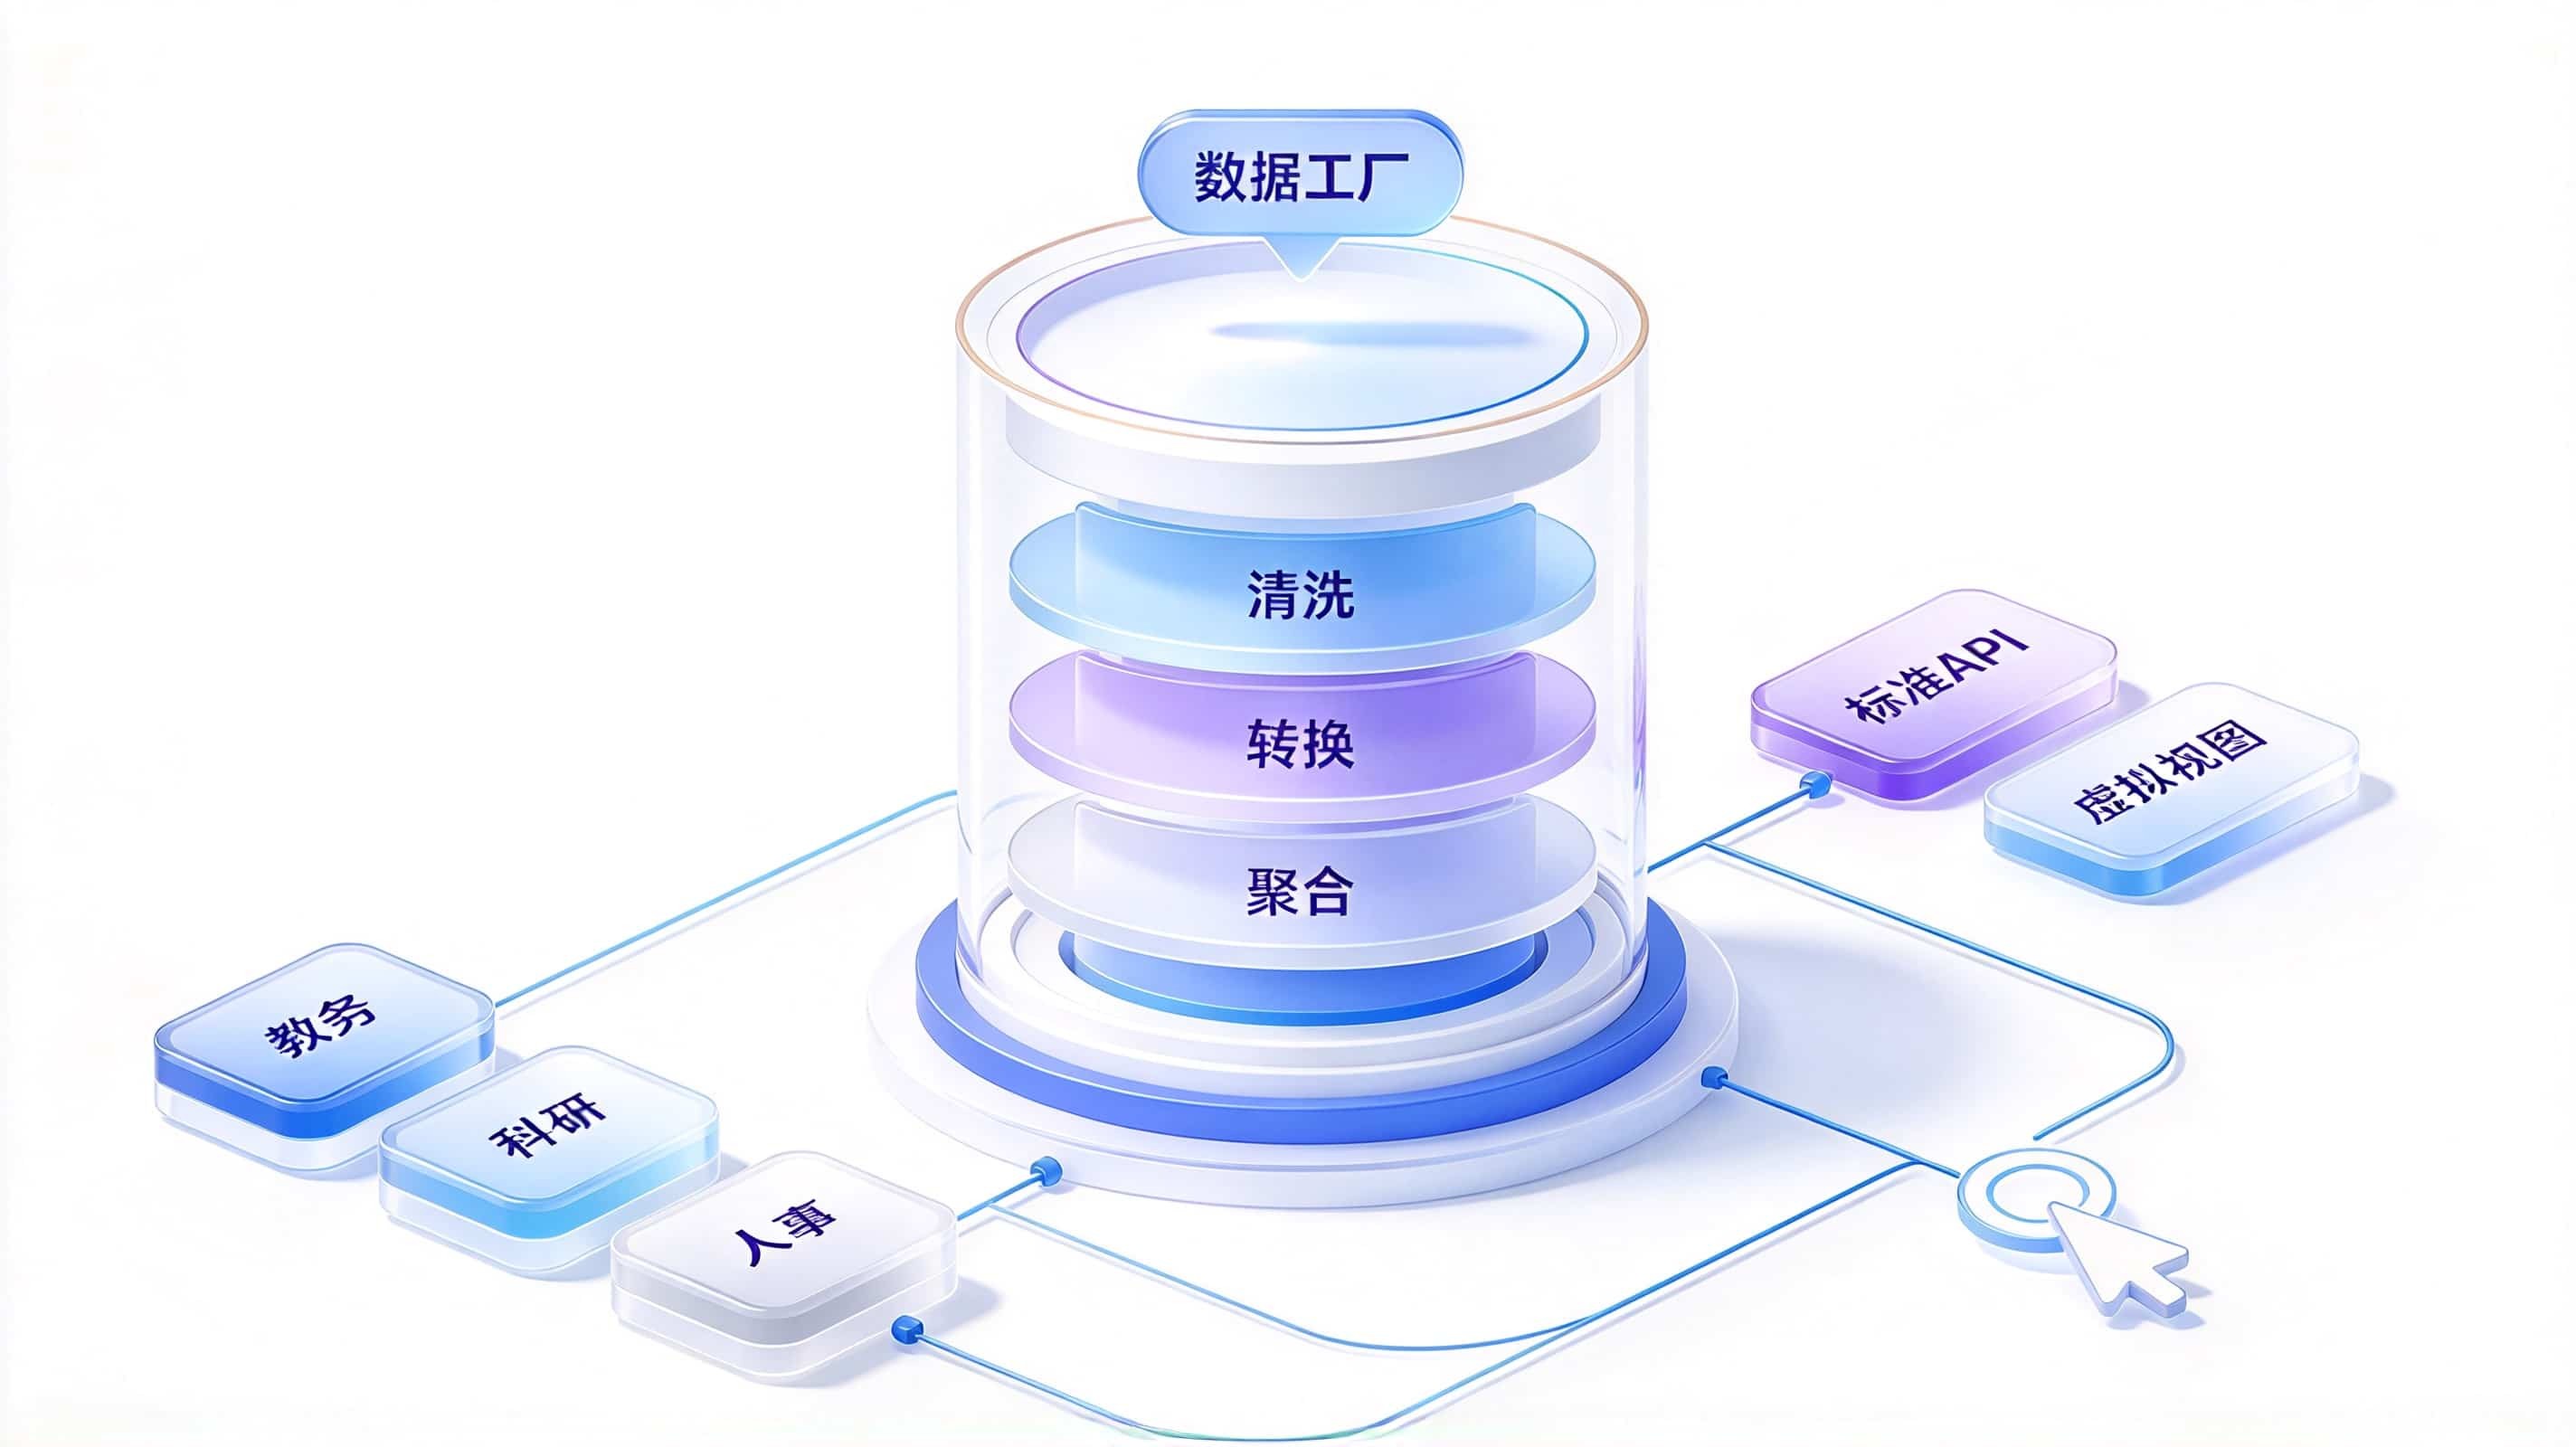
数据工厂则是平台的统一数据处理与管理中枢。在数据运行机制上,数据工厂支持对异构数据的统一接入,通过可视化ETL设计清洗与聚合链路,并自动识别脏数据与缺失值。治理后的数据以标准API、虚拟视图或报表数据集的形式输出,支撑上层业务应用与智能体在安全边界内调用。这种模式让高校的教务、科研数据从静态的存储转变为可调用的能力资产。

4.jpg

四、响应式多端适配与信创安全体系

现代高校的数字化服务需要覆盖PC端管理后台、移动端应用以及各类小程序端,满足师生在办公室、教室、宿舍等不同场景下的使用需求。米缀AI低代码平台提供统一渲染引擎与多端适配层架构,业务规则与数据模型在服务端一次定义,自动适配至PCWeb端、微信小程序等终端,消除多端逻辑碎片化,保持体验一致。

随着AI技术的深度应用,数据安全与合规成为高校信息化不可回避的议题。在低代码开发平台深度解析模型驱动架构与数据运行机制的过程中,安全防护体系是保障其落地的关键。平台在数据交互环节采用了ID化传输脱敏技术,当数据流向大模型时,师生姓名、身份证号、手机号等敏感字段自动替换为唯一ID标识,真实数据不离开校园网络环境。AI仅处理脱敏后的ID数据,返回结果后由平台自动还原。

在基础设施层面,平台全面适配国产芯片(如鲲鹏、海光、飞腾等)、国产操作系统(如麒麟、统信等)以及国产数据库与中间件,满足高校信创合规与数据可控的要求。结合基于角色的细粒度权限管控、端到端加密与全操作审计日志,确保数据在传输与使用过程中的安全性。在系统集成方面,平台提供连接器、数据采集与开放API三种模式,将多源连接能力沉淀为服务目录,打破校园系统孤岛,实现与既有教务、人事系统的顺畅协同。

5.jpg

五、场景实践与知识库资产沉淀

理论架构的价值需在真实校园业务场景中检验。以深圳市某综合性高校的数字化建设为例,该校引入了米缀AI低代码平台,重点覆盖教学辅助、科研管理、学工事务及后勤保障等内部业务。在具体应用中,技术人员通过输入一段包含规则要求的自然语言描述,如“每日可预约实验室10个,工作时间段划分……”,平台在短时间内即可生成包含预约逻辑、排期规则与数据校验的实验室预约应用初版。

在开发知识库的支撑下,平台能够基于行业经验萃取的业务逻辑模板,为AI生成提供精准上下文。通过构建前识别复用、构建中生成校验、构建后沉淀再训练的进化闭环,高校个别项目的经验逐步转化为组织级的应用开发方法库。这种模式使得应用交付不再是单次消耗,而是形成了模板、接口、数据服务与规则资产的持续积累,让高校信息中心从单纯的“项目交付”走向“能力复用”。

6.jpg

结语

综上所述,通过低代码开发平台深度解析模型驱动架构与数据运行机制,我们可以清晰看到技术演进带来的生产范式转变。以米缀AI低代码平台为代表的原生AI底座,通过可视化生成多端应用、自然语言代码生成以及AI/人工双开发模式,将复杂的技术实现封装于模型与智能体之中。在确保安全与信创合规的前提下,这种统一能力底座正支撑着高校内部应用的持续构建、系统协同与数据应用,让智能化能力真正转化为可持续演进的数字化生产力,助力现代高校在管理与服务上实现更深层次的协同与升级。

7.jpg


【免责声明】本栏目部分源自网络及第三方公开渠道的内容,仅作信息分享之用,不代表米软立场或观点。我们力求标注引用来源,若涉及版权侵权争议,敬请通过邮件告知并提交相关凭证,经查证后我们将第一时间移除相关内容。邮箱: szmesoft@szmesoft.com
X

预约交流

请如实填写以下内容,以便米软及时联系您!

米软将在1个工作日内与您取得联系,请您保持手机畅通!

咨询